01
收集真实输入
从业务流程中选择消息与记录,同时包含短请求、上下文缺失和边界模糊的案例。
state = ticket.textDecisionsApi · 聚焦问题,从预设答案中做选择
OpenAI Decisions API 使用 Luna 的能力回答你定义的问题,并从有限的预设答案中选择结果。官方公告介绍了文本或图片上下文,以及分类、请求路由和 Agent 决策等用途。在这里了解评估方法,再通过本站独立服务支持的模型测试实际工作流。
阅读 OpenAI 官方 DevDay 公告本站输出格式示例
静态示意客户消息
“我今天早上被重复扣款了,请尽快退回多扣的款项。”
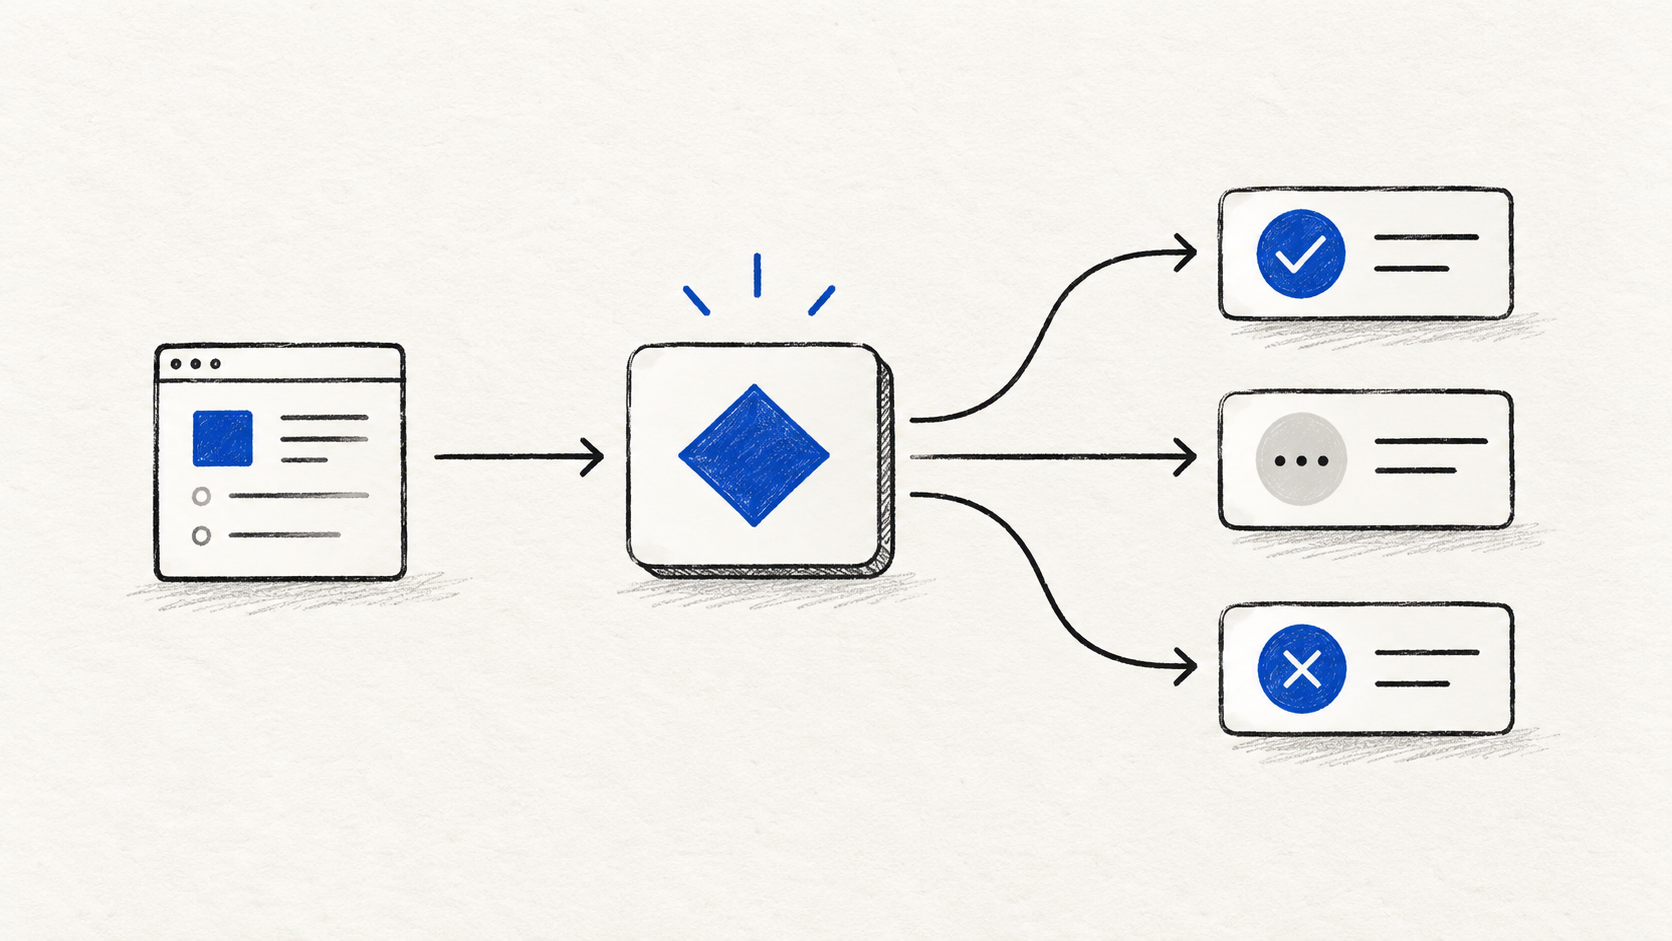
一条消息 → 三项实用判断
Choice
账单问题
选择对应客服队列
是 / 否
96%
是否属于紧急请求
Score
2.8 / 3
在明确的 0–3 量表上判断紧急度
这是本站决策格式的静态示例。数值不是 Luna 的响应、实时调用结果或准确率基准。
01 / 动手测试
输入自己的文本,定义预期答案,并检查请求和响应。工作台实际调用模型选择器中的模型;此页面不提供 Luna 在线演示。
运行请求前,请确认所选模型及工作台当前的使用规则。
02 / 规划评估
有效的比较需要固定任务、清晰标签和有代表性的输入。评估账号可以访问的不同模型时,应尽量保持这些标准一致。
从业务流程中选择消息与记录,同时包含短请求、上下文缺失和边界模糊的案例。
state = ticket.text在比较模型响应之前,先写清允许的标签、每档评分的标准,或是与否各自代表什么。
questions = { intent, urgent }用人工核对过的答案评估输出,记录每个模型的错误、响应时间和实际用量。
answer = result.answers.route上线前明确哪些结果可以直接触发动作,哪些需要补充信息或交给人工复核。
if result.urgent: escalate()03 / 选择实用任务
OpenAI 公告重点介绍了分类、请求路由和 Agent 下一步选择。可以从以下相关场景出发,为 OpenAI Decisions API Luna model 的评估准备实用测试集。
定义账单、技术、账号和其他队列。加入同时涉及多个问题的消息,统计模型是否选中了预期队列。
比较查记录、调用工具、生成文本与人工复核几类动作,并加入信息不完整或缺少执行授权的案例。
把主张与来源段落配对,标记为支持、反驳或无法确定,避免将证据不足直接等同于主张错误。
04 / 确定输出形式
明确的输出形式更容易比较,也更容易接入代码。请选择当前模型支持的类型;OpenAI 模型具体的输出约定应以其官方文档为准。
定义少量相互区分的选项,并说明它们的边界。案例可能无法归类时,保留其他或人工复核选项。
逐档描述紧急度、相关性或完整性。按偏差等级检查结果,区分轻微分歧与可能影响业务的严重错误。
写清是与否各自代表什么,再使用未参与调试的案例检查返回概率,最后选择适合业务的自动执行阈值。
从评估走向接入
这段服务端示例调用本站 /v1/systemone 接口,使用 typesafe/jev-1.13 模型,展示 state、questions、认证与类型化答案的配合方式。接入 OpenAI 时,请从可访问模型的官方文档获取模型 ID 和请求格式。
阅读本站 API 文档POST /v1/systemone · 本站接口
JavaScript 示例 · typesafe/jev-1.13 · 非 Luna API 请求
const response = await fetch(
  "https://decisionapi.net/v1/systemone",
  {
    method: "POST",
    headers: {
      "Authorization": `Bearer ${DECISIONS_API_KEY}`,
      "Content-Type": "application/json"
    },
    body: JSON.stringify({
      model: "typesafe/jev-1.13",
      state: ticket,
      questions: { route: { type: "choice", criteria } }
    })
  }
);
05 / 了解服务
注册后即可获得用于测试的赠送积分,创建账号、加载示例、检查预算,并运行你的第一组问题。
Playground、API 与评估工作流共用同一积分余额,购买的积分长期有效。
查看请求历史与积分变动,并用请求 ID 将 API 调用和用量记录对应起来。
以下套餐适用于本站服务及已支持的模型。请根据测试与接入需求选择;页面金额不是 OpenAI Luna 模型的官方价格。
购买本站套餐不会授予 OpenAI 模型访问权限。模型可用性、开放资格和价格请通过 OpenAI 官方文档及你的 OpenAI 账号确认。
重要说明:Decisions API 目前处于小范围测试阶段
Decisions API 尚未全面开放,目前仅提供小范围测试。我们会按照付款顺序逐步开放调用权限,并通过邮件通知。等待期间,你可以先使用 Jev AI 等其他 Decision API。
入门版
适合验证一个真实工作流,从在线测试走到第一次 API 调用
专业版
适合将分类、路由和安全判断稳定接入线上产品
企业版
适合多工作区、团队协作与定制化生产集成,额外赠送 10% 额度
用自己的数据比较
先测试本站可用模型,再把同一套经过人工核对的测试集用于其他有权限访问的模型。分别记录决策质量、响应时间和实际成本,不要把不同提供商返回的概率值直接视为同一种指标。
Jev
为分类、评分和是非判断任务建立基线
Laya
使用相同输入和判断标准比较结果
Kev、Solar 与 Span
加入其他可用模型,并检查各自支持的问题类型
最近博客
了解 Jev 的产品、技术和集成进展。
AI API
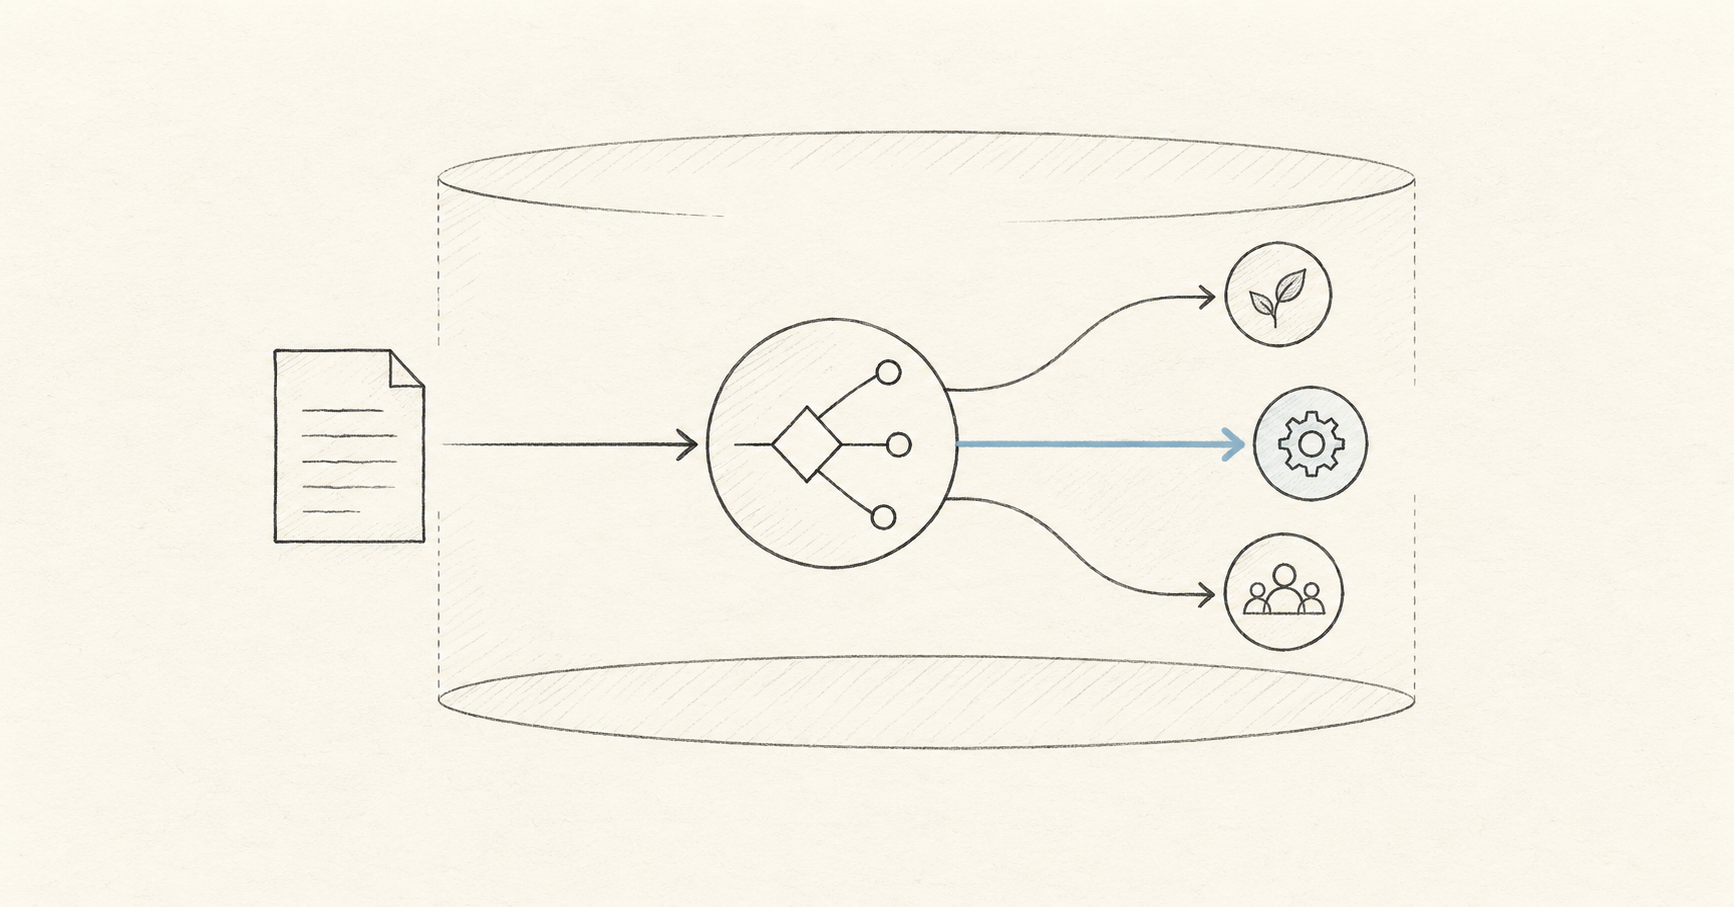
深入比较 Decisions API vs Jev 的平台与模型差异、类型化输出和 API 接入方式,学习质量评估、成本核算、迁移步骤与实用选型方法。
2026年10月3日 · 15 分钟阅读
AI 模型
了解 OpenAI Decisions API Luna 模型的已确认能力与预览状态,学习有限答案决策、请求路由、效果评估和生产上线方法。
2026年10月3日 · 16 分钟阅读
开发指南
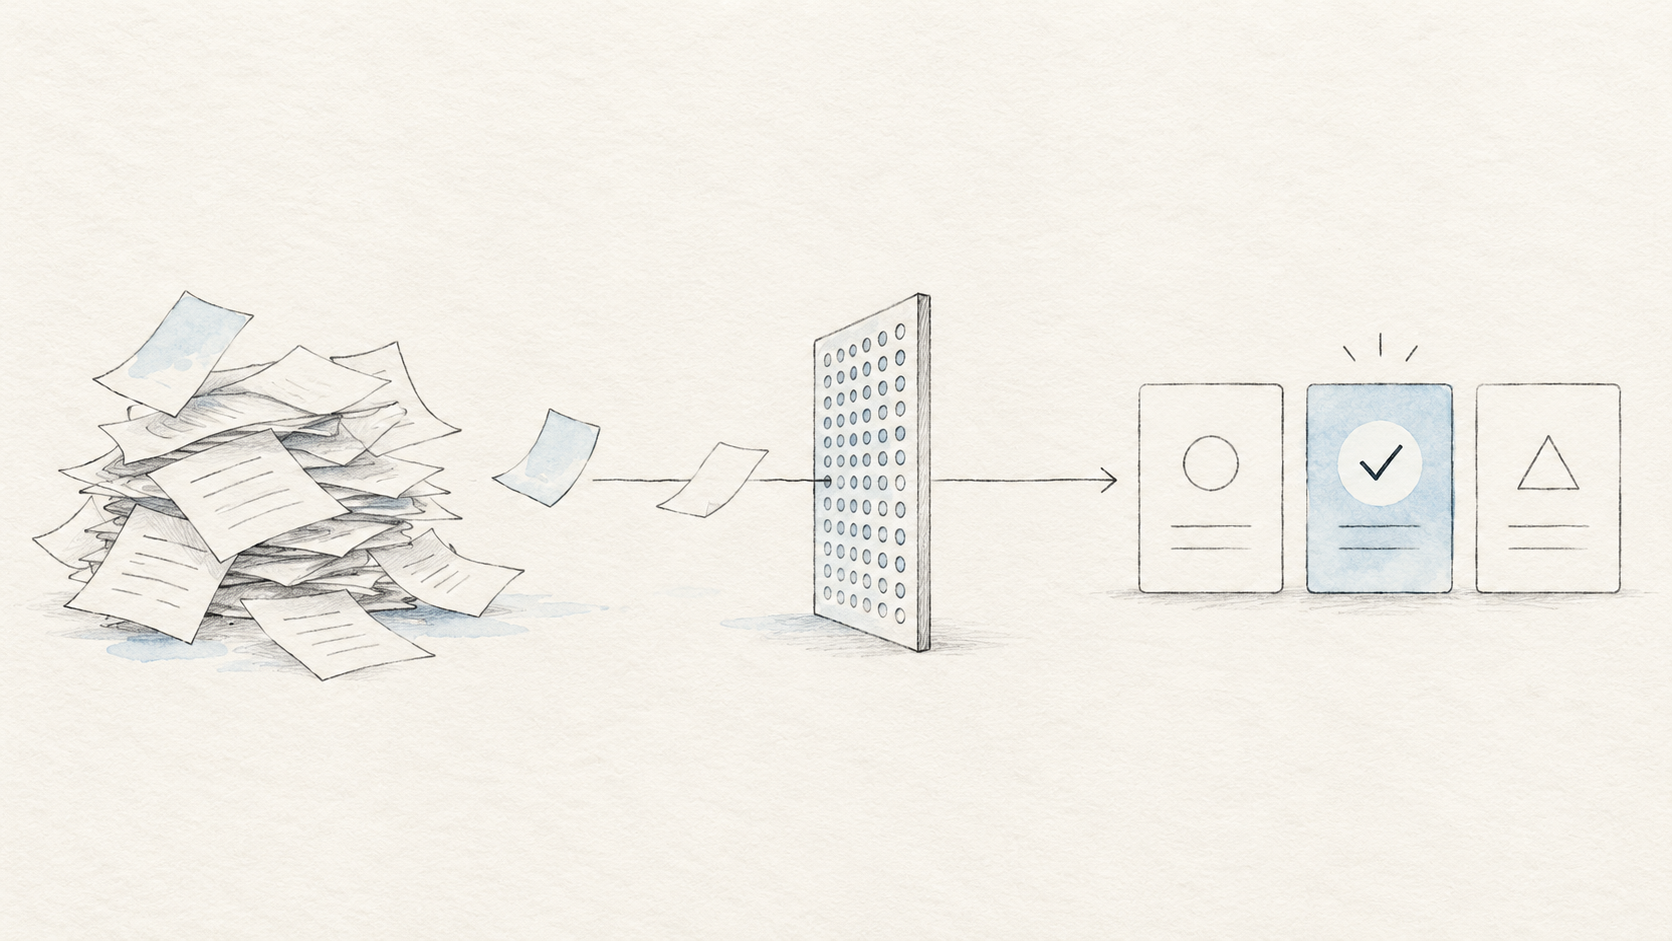
构建 Decision API OpenAI 工作流:从类型化输出、REST 示例到质量评估和生产控制,厘清不同 API 协议,让 AI 决策可靠接入业务。
2026年10月3日 · 16 分钟阅读
AI API
一份面向开发者的 Decisions API 文档与示例指南,介绍 REST 请求格式、Choice / Score / Noul 问题类型、客服分流案例和生产环境安全实践。
2026年10月1日 · 13 分钟阅读
了解已公布的能力、实用的比较步骤,以及适合当前工作流的接入方式。