AI API
Decisions API 文档与示例:请求格式、问题类型和生产接入
一份面向开发者的 Decisions API 文档与示例指南,介绍 REST 请求格式、Choice / Score / Noul 问题类型、客服分流案例和生产环境安全实践。
Decisions API 文档与示例:请求格式、问题类型和生产接入
上线说明: OpenAI Decisions API 即将上线。在 OpenAI 发布最终公开协议之前,本文暂时使用当前可用的 Jev AI 格式——共享
state、类型化questions和结构化答案——来演示决策 API 的工作方式。下面的示例用于说明接入模式,并不是 OpenAI 官方最终请求格式。
如果你正在搜索 decisions api documentation 或 decisions api example,最核心的理解其实很简单:发送一段应用状态,描述一个或多个边界清晰的问题,然后接收可以被代码读取的类型化答案。它适合分类、路由、评分、安全检查,以及所有“软件需要一个信号,而不是另一段生成文本”的场景。
本文把公开的 Decisions API 文档 整理成一条可落地的接入路径,覆盖 REST 端点、请求字段、Choice / Score / Noul 三种问题类型、完整的客服工单示例、响应处理,以及应用自身必须保留的安全控制。字段和模型能力可能变化,关键业务上线前请以实时文档为准。
目录
- Decisions API 解决什么问题
- 请求格式
- State:给每个问题提供正确上下文
- 问题类型:Choice、Score 和 Noul
- 一个完整的 Decisions API 示例
- 如何读取结构化响应
- 一次请求提出多个问题
- 错误处理、重试与不确定性
- 从 Playground 走向生产
- 什么时候适合使用决策 API
- 常见问题
Decisions API 解决什么问题
传统聊天请求让模型生成语言;决策请求则让模型做一个小而明确的判断,供周围程序使用。应用定义问题和答案空间,模型提供语义信号,而确定性代码负责最终动作。
Decisions API 当前公开的评估端点是:
POST https://decisionapi.net/v1/systemone
请求使用服务端 API Key,并在 JSON body 中提供三个必填顶层字段:
model:执行判断的可用决策模型。state:提供共享上下文的文本、对象或文本数组。questions:需要针对该状态评估的问题 Map。
问题 key 由应用定义,响应会使用相同的 key 返回答案,因此很容易把答案连接到对应的控制流。它们不是发送给底层模型的隐藏指令;真正的问题内容放在 instructions 中,需要时再通过 criteria 描述判断边界。
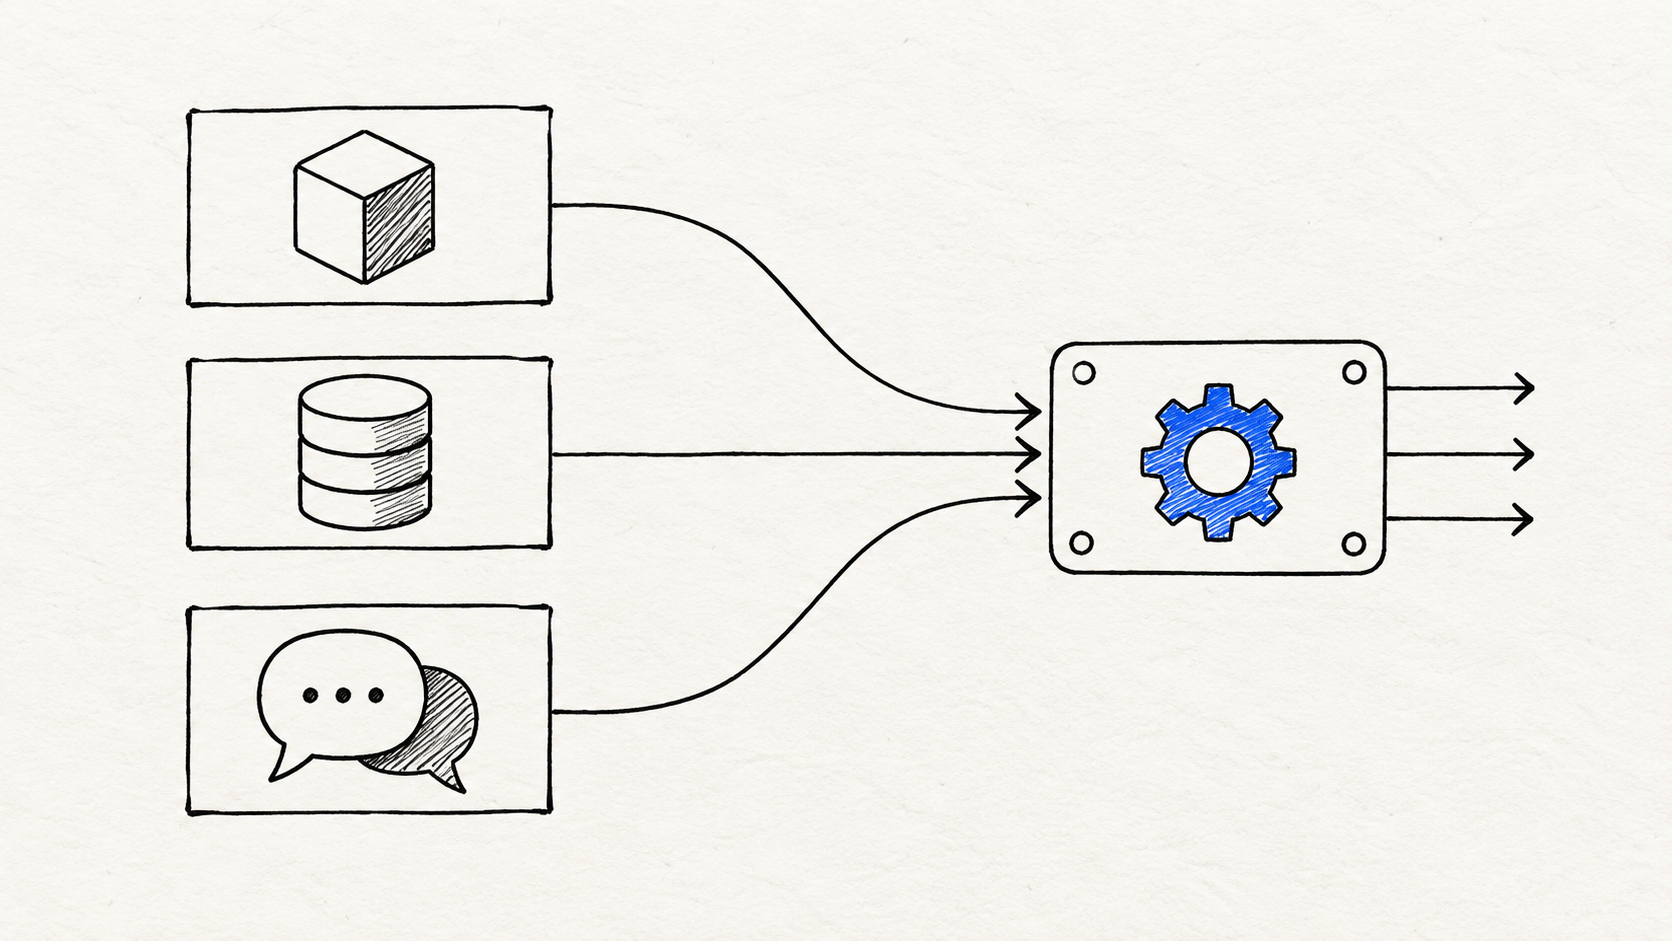
这个端点的定位很明确:它不是聊天助手、数据库,也不是授权服务。它可以判断工单更像 billing,判断某个工具动作是否有风险,或判断证据是否支持一个结论;但应用仍然必须校验数据、检查权限、设置阈值,并决定是否真的执行动作。
请求格式
最小可用请求如下:
{
  "model": "typesafe/jev-1.13",
  "state": "Help! My payouts have been failing for 3 days.",
  "questions": {
    "is_urgent": {
      "type": "noul",
      "instructions": "Does this message convey urgency?"
    }
  }
}
请求需要以下 headers:
Authorization: Bearer <API_KEY>
Content-Type: application/json
API Key 必须保存在服务端,不要放进浏览器 JavaScript、公开仓库、客户端环境变量,或会展示给最终用户的 prompt。浏览器可以调用你自己的后端,再由后端调用 Decisions API。
model 必须是当前可用的模型 ID。实时的模型列表是可用性与问题类型的准确信息来源。不同模型的延迟、价格、语言覆盖和质量可能不同,因此建议在评估日志中记录实际使用的模型 ID。
让 State 足够小且足够相关
state 是每个问题都会读取的上下文,可以是:
- 简单工单、消息或声明对应的字符串;
- 带字段名的 JSON 对象;
- 需要一起判断的多段文本数组。
只放回答当前问题所需的证据。例如客服路由可能需要客户消息、产品区域、账户等级和最近事件,通常不需要完整账户历史或无关的对话记录。更小的 State 更容易审计,也更节省成本,并能减少干扰信息。
当前文档描述的输入形式是文本、JSON 对象和文本数组。不要因为其他模型或产品支持多模态,就默认这个端点也支持图片、音频或视频;接入前要核对当前 API 契约。
一次只问一个边界清晰的问题
好的问题有明确目标,也有有限的解释空间:
- 这个案例应该进入哪个已批准的团队?
- 按定义的刻度,这个问题有多紧急?
- 这个工具调用是否需要人工复核?
不要把互不相同的判断揉成一句“分类工单、决定是否退款并写一封回复”。应该拆成多个问题,并把退款动作放在确定性权限和必要的人工审批之后。
问题类型:Choice、Score 和 Noul
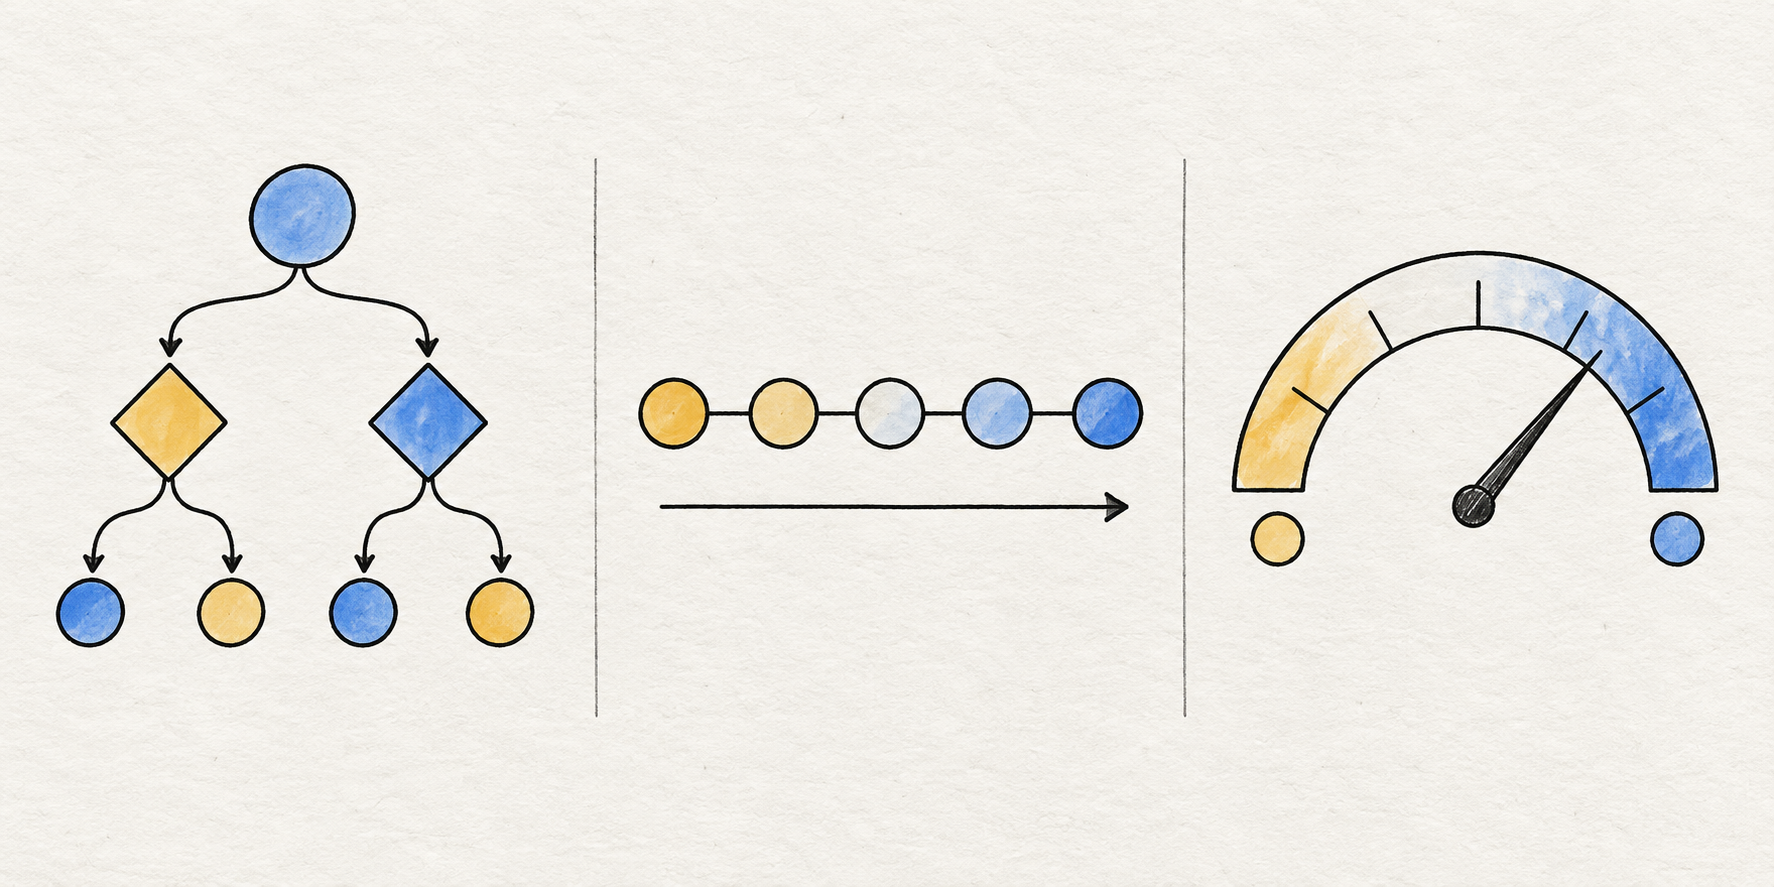
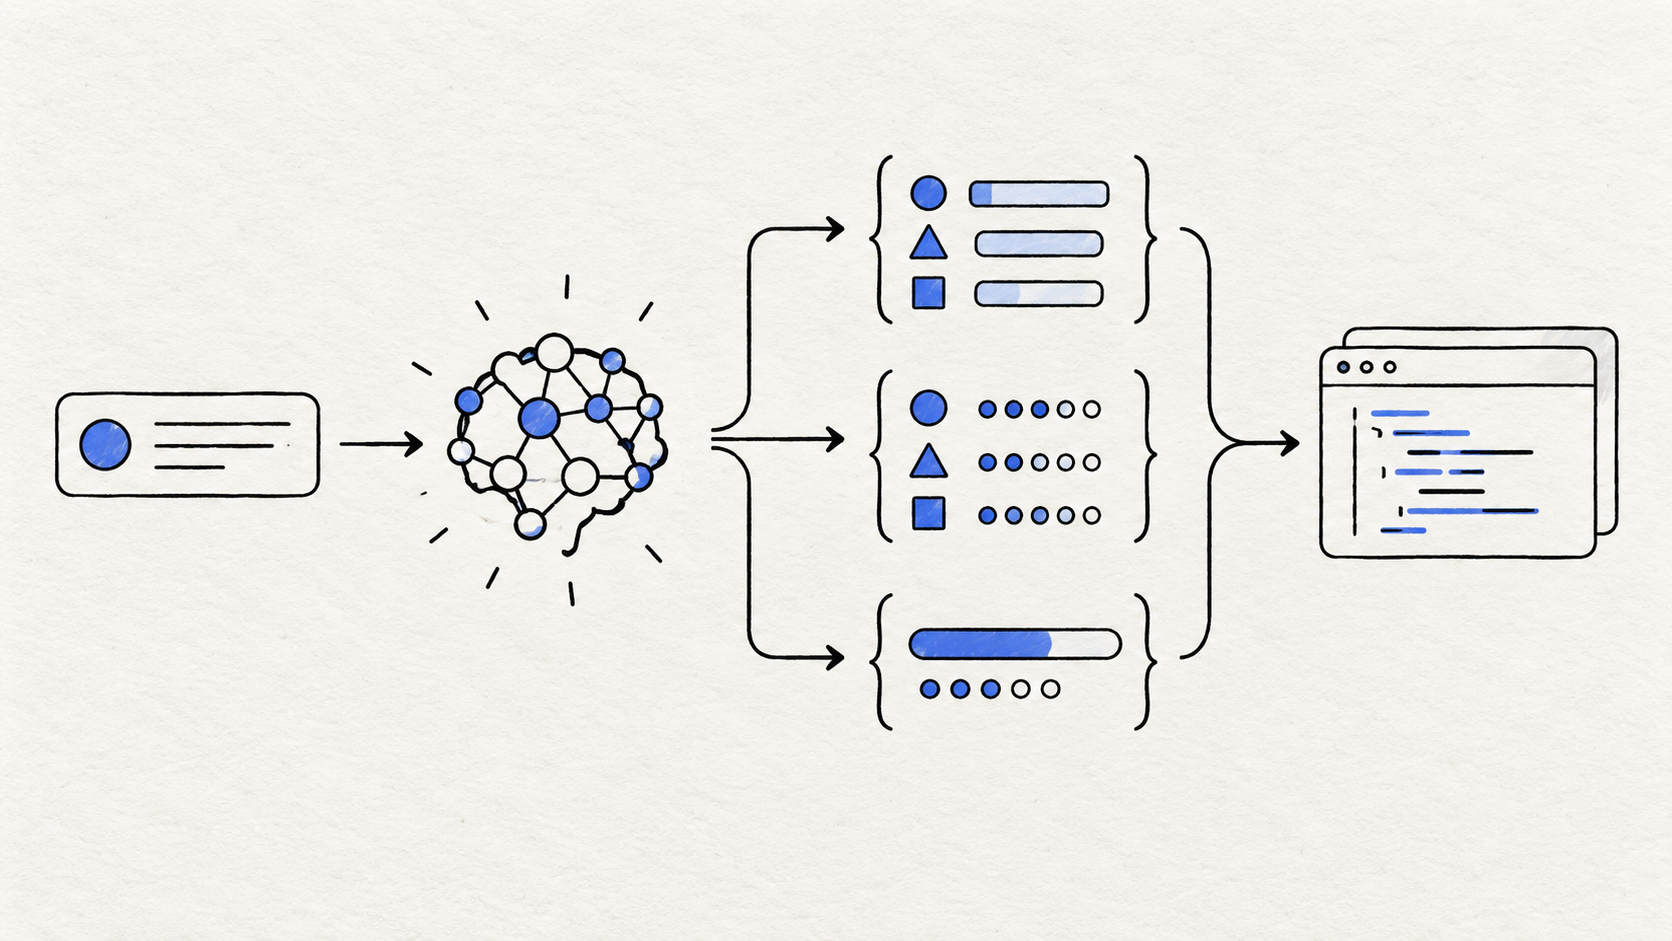
Decisions API 提供三种实用的问题形状:分支选择、有序评分和是非概率。下图以草图方式展示它们;实际支持类型取决于所选模型。
Choice:从允许的标签中选择一个
当应用需要从预定义集合中选择一个答案时使用 choice,例如 billing、technical、sales 或 manual_review。criteria 对象为每个选项提供描述,让选项之间的边界更清楚,也方便人工评估。
{
  "type": "choice",
  "instructions": "Which team should handle this customer message?",
  "criteria": {
    "billing": "Payments, invoices, refunds, or duplicate charges",
    "technical": "Bugs, outages, API failures, or integration problems",
    "sales": "Pricing, upgrades, new accounts, or plan questions",
    "manual_review": "The message does not fit the approved routes"
  }
}
当真实输入可能超出前三类时,一定要加入兜底选项。把陌生案例强行塞进一个“看起来最像”的队列,通常比进入人工复核更危险。
Score:按照有序标准评分
当答案代表紧急程度、完整度、风险、满意度或相关性这样的有序位置时使用 score。criteria 是从低到高排列的数组。响应里的分数可以按概率加权,因此可能落在离散等级之间。
{
  "type": "score",
  "instructions": "How urgent is this support request?",
  "criteria": [
    "No operational impact",
    "Work is slowed but a workaround exists",
    "A customer or internal workflow is blocked",
    "Critical and time-sensitive"
  ]
}
等级必须有业务定义。除非解释每个等级会导致什么不同,否则“低、中、高”对不同团队可能代表完全不同的事情。
Noul:提出聚焦的是非问题
当你需要一个二元判断时使用 noul。noul 的取值范围是 0 到 1,表示答案为“是”的概率。可以通过 criteria 解释 true 和 false 在当前工作流中分别代表什么。
{
  "type": "noul",
  "instructions": "Does this request need immediate human attention?",
  "criteria": {
    "true": "The request is explicitly time-sensitive or blocks a critical workflow",
    "false": "The request is not time-sensitive and can follow the normal queue"
  }
}
Noul 适合证据校验、审批闸门、内容审核和升级条件,但它不是正确性保证。应该把概率交给策略判断,而不是把概率本身当成跳过策略的许可。
一个完整的 Decisions API 示例
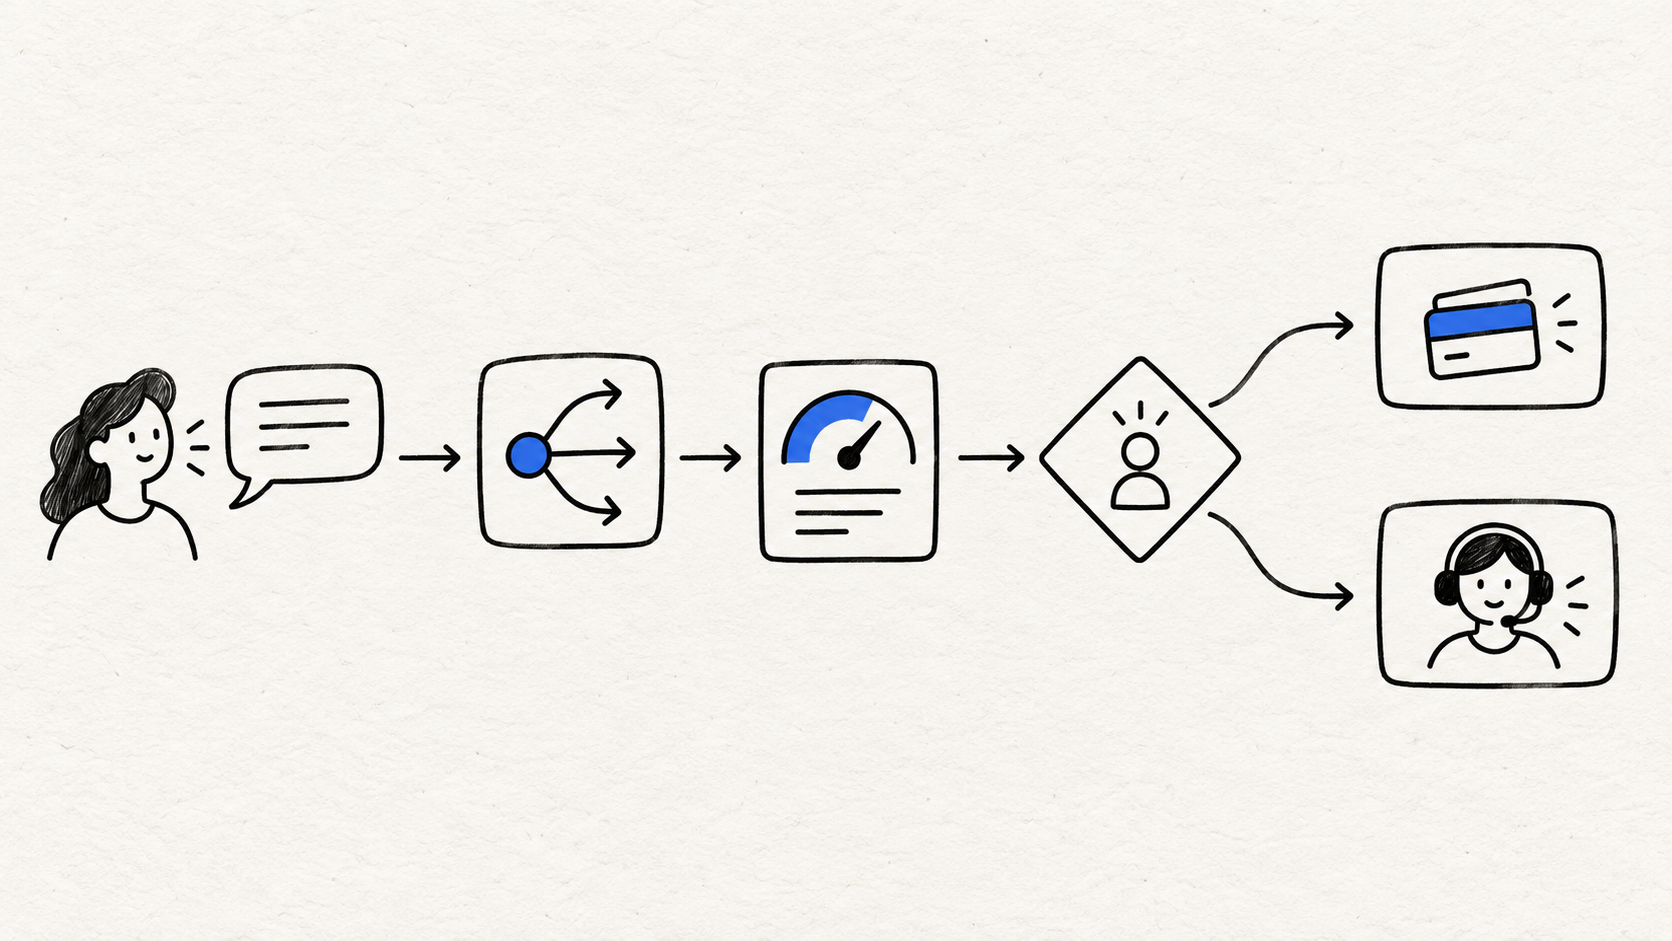
下面以客服消息为例:同时完成工单路由、紧急程度评分,以及是否需要立即人工介入的判断。三个问题读取同一个 State,并行评估。
1. 定义请求
{
  "model": "typesafe/jev-1.13",
  "state": {
    "message": "I was charged twice for my annual plan and need a refund before payroll closes today.",
    "customer_tier": "business",
    "recent_events": ["payment_succeeded", "payment_succeeded"]
  },
  "questions": {
    "department": {
      "type": "choice",
      "instructions": "Which approved team should own this support case?",
      "criteria": {
        "billing": "Payments, invoices, refunds, or duplicate charges",
        "technical": "Bugs, outages, API failures, or integration problems",
        "account": "Login, identity, permissions, or account access",
        "manual_review": "The case is ambiguous or outside the approved routes"
      }
    },
    "urgency": {
      "type": "score",
      "instructions": "How urgent is this case for operations?",
      "criteria": [
        "Normal queue",
        "Needs same-day attention",
        "Customer workflow is blocked",
        "Critical and time-sensitive"
      ]
    },
    "needs_human_now": {
      "type": "noul",
      "instructions": "Does this case need immediate human attention?",
      "criteria": {
        "true": "A time-sensitive business impact or sensitive refund decision is present",
        "false": "The case can be handled by the normal support workflow"
      }
    }
  }
}
2. 在服务端调用端点
下面的 Node.js 示例把密钥放在 DECISIONS_API_KEY 中,并把远程响应视为未知数据,只有通过本地校验后才进入业务逻辑。
const response = await fetch('https://decisionapi.net/v1/systemone', {
  method: 'POST',
  headers: {
    Authorization: `Bearer ${process.env.DECISIONS_API_KEY}`,
    'Content-Type': 'application/json',
  },
  body: JSON.stringify(request),
});

if (!response.ok) {
  throw new Error(`Decisions API failed with ${response.status}`);
}

const result: unknown = await response.json();
如果你的产品有后端框架,可以把这段调用封装成一个小型 provider adapter。要区分传输错误、响应校验错误和低置信度结果。请求超时不等于确定的 false,未知 Choice 也不等于 manual_review,除非你的代码明确做了这个映射。
3. 对响应应用业务策略
例如,应用可以把案例路由给 billing,提高优先级,并在 Noul 概率超过阈值时送入人工队列。模型不应该直接退款,也不应该直接修改工单。
const answers = readAndValidateAnswers(result);

if (answers.department.choice === 'manual_review') {
  return sendToHumanQueue('Unapproved or ambiguous route');
}

if (answers.needs_human_now.noul >= 0.8) {
  return sendToHumanQueue('High-probability urgent case', answers);
}

return routeTo(answers.department.choice, {
  urgency: answers.urgency.score,
  source: 'decisions-api',
});
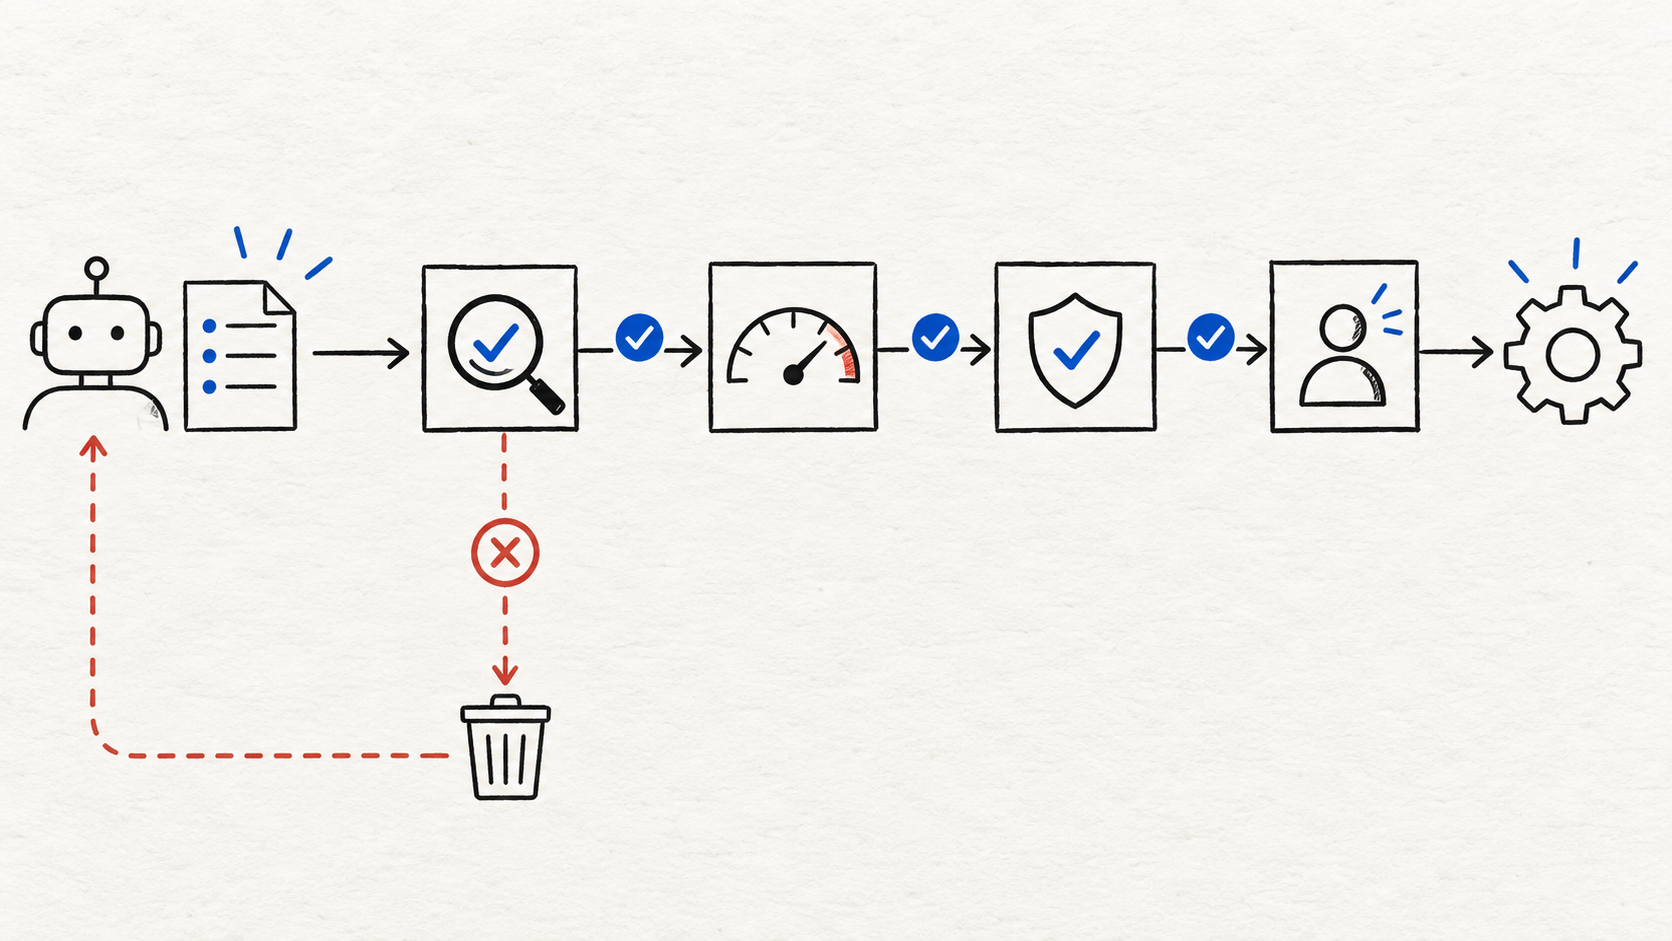
这就是生产环境最重要的边界:决策模型提供信号,应用负责权限、最终动作、副作用和审计记录。
如何读取结构化响应
一个最小的 Noul 响应大致如下:
{
  "model": "typesafe/jev-1.13",
  "answers": {
    "is_urgent": {
      "type": "noul",
      "noul": 0.95
    }
  },
  "usage": {
    "input_tokens": 296,
    "output_tokens": 20
  }
}
响应包含实际使用的模型、以问题 ID 为 key 的 answers Map,以及 usage 信息。每个 answer 的 type 与请求中的问题一致:
- Choice 返回
choice、每个选项的probabilities和confidence。 - Score 返回概率加权的
score、legend、每个等级的probabilities和confidence。 - Noul 返回
noul,也就是答案为“是”的概率。
概率和置信度适合用于阈值、路由、选择性自动化和评估,但不是业务准确率保证。模型可能“自信地错”,即使概率校准良好,也只是估计而不是权限。建议记录问题版本、criteria、模型 ID、原始答案、采用的阈值、最终动作和后续人工结果,这样才能评估完整系统。
一次请求提出多个问题
多个问题会针对同一个 State 并行评估。当工作流同时需要路由、优先级和人工复核信号时,这种方式很有用,可以减少编排代码,也让一组证据保持在同一个请求里。
并行不意味着问题之间应该相互依赖。如果问题 B 必须读取问题 A 的结果,应该在应用代码中明确这种依赖,或携带新的 State 发起第二次请求。保持问题独立,更容易标注数据、比较模型,也更容易发现是哪一个判断导致了错误分支。
问题 ID 应该服务于机器而不是写成长句,例如 department、urgency、needs_human_now 或 evidence_supported。它们的含义要保持稳定。如果修改了 rubric 或 criteria,应该给问题定义做版本管理,否则历史结果会失去可解释性。
错误处理、重试与不确定性
客户端需要同时面对普通 HTTP 错误、响应格式异常和模型结果不符合预期的情况。一个实用的客户端至少应该:
- 在发请求前拒绝缺失或为空的 API Key;
- 设置有限超时,并记录服务返回的 request ID(如果有);
- 只对瞬时网络或服务端错误使用小幅指数退避重试;
- 不要盲目重试参数校验错误或问题定义错误;
- 把缺失答案、未知 Choice 和非法分数视为响应校验失败;
- 将高风险或低置信度案例送入安全兜底;
- 脱敏记录 State,同时保留足够的元数据用于排查。
兜底应该是真正的产品路径:人工队列、确定性规则、延迟重试,或者要求用户补充信息。不要在请求失败时静默执行更危险的动作。如果 API 正在判断一个破坏性工具调用是否安全,调用失败就应该拒绝执行并要求确认。
从 Playground 走向生产
Decisions API Playground 适合把模糊的自动化想法变成具体的 State 和问题。建议同时测试简单、模糊和对抗性样例,每次只改变一个输入。记录可信人工审核者会选择什么,而不只是观察输出“看起来像不像”。
上线前准备一组能够代表真实分布的评估集:
- 应该自动处理的普通案例;
- 两个标签之间的边界案例;
- 信息不完整或相互矛盾的 State;
- 必须人工审核的敏感案例;
- 对抗式措辞和 prompt injection 尝试;
- 正确答案是兜底选项的案例。
至少测量路由准确率、评分一致性、误放行率、误拦截率、人工复核量、延迟、token 用量,以及每个完整业务动作的成本。阈值应该根据错误代价来调,而不是套用一个通用置信度。支付审批、内容审核和低风险标签不应该共用同一个自动化阈值。
API Key 放在服务端 secret 中,用运行时 schema 校验响应。对模型、路由、工具和副作用建立确定性 allowlist。在隐私政策允许的范围内,记录足够的信息来重现决策。服务契约变化时,重新查看实时的工作流说明和 API 参考。
服务提供 welcome credits 供测试,当前的价格页面描述了 credit pack 和并发限制。这些内容可能变化,不要把价格和额度硬编码成业务策略。
什么时候适合使用决策 API
当满足以下条件时,Decisions API 通常很合适:
- 应用可以列出可接受的结果;
- 多个小问题共享同一份输入状态;
- 结果由代码消费,而不是作为最终文案展示给人;
- 你能定义不确定性和兜底路径;
- 业务动作仍然由应用控制。
如果产品需要起草内容、解释、综合信息、开放式研究,或者无法缩小为有限答案空间的计划,就应该使用通用语言模型。很多真实系统会组合两者:通用模型处理语言理解,快速决策层负责在执行前完成分类、路由、评分或窄条件检查。
可以用下面这条路径理解它:
state + 有边界的问题 -> 类型化决策 -> 本地策略 -> 动作或人工复核
API 让第一步更容易集成,但最后两步仍然是应用的责任。
常见问题
Decisions API 是聊天 API 吗?
不是。它面向标签选择、有序评分和是非概率等结构化决策。需要生成文章、解释或开放式推理时,应使用聊天或生成接口。
应该调用哪个端点?
DecisionsApi 公开文档中的端点是 POST https://decisionapi.net/v1/systemone。请求中发送 model、state 和 questions,并使用服务端 Bearer API Key。上线前请再次核对当前的接口参考。
一次请求可以提出多个问题吗?
可以。多个问题共享同一个 State 并行评估。为每个问题设置稳定 ID,并分别校验每个答案。
高概率等于高准确率吗?
不等于。概率和置信度可以帮助设置阈值和人工复核路径,但不是保证。应该使用自己业务中的标注样本评估校准情况和最终业务结果。
Decisions API 可以直接退款或调用工具吗?
应用可以用答案选择路径,但模型不应该成为唯一授权层。权限、allowlist、确认要求和副作用都应该保留在确定性应用代码中。
什么样的 Decisions API 示例最有价值?
有价值的示例应该同时展示真实 State 结构、一个边界清晰的问题、答案集合或评分标准、请求体、响应形状,以及应用如何消费答案。上面的客服路由示例把这六个部分都展示出来,便于改造成自己的业务流程。
结语
Decisions API 的实际契约并不复杂:选择可用模型,发送最小且有用的 State,定义类型化问题,读取结构化答案,再让应用决定下一步。先在 Playground 中验证,再用真实样本评估;把 API Key 留在服务端;对于错误代价高的动作,始终保留人工复核。
这样就能从一个 Decisions API 示例 走向可维护的生产接入,同时不会把模型判断误当成业务授权。